
🧠 ¿Qué es AnythingLLM y por qué deberías prestarle atención?
AnythingLLM es una de esas herramientas que, cuando la pruebas, te preguntas por qué no la conocías antes. No es un chatbot en la nube más, ni un servicio que te cobra por cada token que usas. Es una aplicación de escritorio que puedes instalar en tu ordenador y que convierte cualquier documento en una base de conocimiento consultable con IA, todo ejecutándose localmente en tu máquina. La empresa detrás es Mintplex Labs, un equipo que pasó por Y Combinator en el verano de 2022, y que lanzó la primera versión pública en junio de 2023. En diciembre de ese mismo año, el proyecto se abrió completamente bajo licencia MIT, lo que significa que cualquiera puede ver el código, modificarlo y usarlo sin restricciones comerciales.
La propuesta es directa: quieres hablar con tus documentos, tus notas, tu código, sin enviar nada a la nube. El problema que resuelve es el de la privacidad y el coste. Cada vez que subes un archivo a ChatGPT o a un servicio similar, ese documento sale de tu ordenador. Y cada vez que haces una consulta, consumes tokens que se traducen en facturas mensuales que pueden dispararse. AnythingLLM elimina ambos problemas: el procesamiento ocurre en tu máquina, y no hay coste por token porque no estás usando la infraestructura de nadie más que la tuya.
No es una herramienta para todo el mundo, y lo digo claro desde el principio. Si lo que buscas es un asistente generalista que escriba ensayos sobre la Revolución Francesa, ChatGPT es más directo. AnythingLLM brilla cuando tienes un corpus de documentos propios y necesitas extraer información, resumir, comparar o simplemente preguntar cosas que están enterradas en PDFs, notas de Obsidian o archivos de código.
⚙️ Funciones principales: lo que realmente hace AnythingLLM
He probado la herramienta durante varias semanas y estas son las funciones que uso de verdad, no las que están en la web oficial para hacer bulto:
- RAG (Retrieval-Augmented Generation) con tus documentos: Este es el corazón del producto. Subes archivos (PDF, DOCX, TXT, Markdown, código, prácticamente cualquier cosa), AnythingLLM los procesa, los divide en fragmentos y los indexa en una base de datos vectorial. Cuando haces una pregunta, el sistema busca los fragmentos más relevantes y los pasa al modelo de lenguaje como contexto para generar la respuesta. El resultado: respuestas basadas en tus documentos, no en alucinaciones del modelo.
- Modo Agent con llamada a herramientas: En lugar de solo buscar en documentos, el agente puede usar herramientas externas. Búsqueda web, scraping de páginas, ejecución de código, conexión con MCP (Model Context Protocol). Se activa con una mención @agent en el chat. La fiabilidad varía según el modelo que uses: los modelos comerciales como GPT-4 o Claude manejan mejor las llamadas a herramientas que los modelos open source.
- Model Router híbrido local + nube: Esta es una de las funciones más interesantes que han añadido recientemente. Puedes definir reglas para que ciertas consultas se enruten a un modelo local (Ollama, LM Studio) y otras a un modelo en la nube (OpenAI, Anthropic). Consultas simples van al modelo local, que es gratis. Consultas complejas que requieren razonamiento avanzado van a la nube, donde pagas por uso. Todo transparente para el usuario, todo definido por ti.
- Scheduled Jobs (tareas programadas): Puedes configurar agentes que se ejecuten automáticamente en un horario que definas. Un resumen matutino de tus documentos nuevos, un informe semanal de cambios en una web, una monitorización periódica de algo que te interese. Se configura con un builder visual, sin necesidad de saber sintaxis cron.
- Memoria automática y personalización: AnythingLLM extrae información relevante de tus conversaciones y la almacena en una memoria que el asistente puede usar después. Puedes tener memorias específicas de un workspace o memorias globales que se aplican a todas las conversaciones. Tú controlas qué se recuerda y qué no.
- Workspaces múltiples y aislados: Puedes crear diferentes espacios de trabajo, cada uno con sus propios documentos y su propia configuración. Un workspace para tus notas de proyectos, otro para documentación técnica, otro para investigación personal. Cada uno mantiene su propio contexto y su propia base de conocimiento.
- Extensión de navegador: Una extensión oficial que te permite enviar páginas web o texto seleccionado directamente a un workspace de AnythingLLM mientras navegas. Útil para ir construyendo una base de conocimiento sobre la marcha.
- Embedded Chat Widget (solo Docker): Si despliegas AnythingLLM con Docker, puedes generar un widget de chat que incrustas en una web. Configuras el modo (Chat o Query), el dominio permitido, límites de mensajes. Útil para documentación interna o para dar soporte a usuarios sin que tengan que instalar nada.
✨ Lo que la diferencia de otras herramientas
Aquí es donde merece la pena pararse. Hay muchas herramientas de RAG. Hay muchas aplicaciones de escritorio para LLMs. Pero AnythingLLM hace algunas cosas que no he visto en otras.
Es la GUI más accesible para RAG local. Herramientas como PrivateGPT o LocalGPT requieren usar la línea de comandos, instalar dependencias de Python, pelearse con entornos virtuales. AnythingLLM se instala como cualquier aplicación de escritorio: descargas, ejecutas, siguiente, siguiente, listo. La barrera de entrada es prácticamente cero. Eso no significa que sea menos potente, significa que más gente puede usarla.
El Model Router es una idea que debería copiar todo el mundo. Hasta ahora tenías que elegir: todo local (privado pero limitado) o todo en la nube (potente pero caro y con datos fuera). AnythingLLM rompe esa dicotomía. Puedes tener un modelo local para el 80% de tus consultas y reservar la API de pago para las que realmente necesitan razonamiento avanzado. En la práctica, esto puede reducir tu factura de API a una fracción de lo que pagarías usando solo la nube.
El modo Agent con MCP es un diferenciador técnico real. MCP es un protocolo abierto que permite a los modelos de lenguaje conectarse con herramientas externas de forma estandarizada. AnythingLLM lo soporta en su despliegue Docker, aunque no en la versión Cloud. Para desarrolladores que quieren integrar su asistente con flujos de trabajo existentes, esto abre posibilidades que otras herramientas no ofrecen.
La licencia MIT lo cambia todo. No es solo que sea gratis. Es que puedes usarlo en tu empresa sin preocuparte por licencias, puedes modificarlo para adaptarlo a tus necesidades, puedes auditarlo si tienes requisitos de seguridad. El código está ahí, abierto.
🎯 Dónde se usa de verdad: casos prácticos
Después de probarlo en varios escenarios, estos son los casos donde tiene más sentido:
Gestión de conocimiento personal: Si tienes cientos o miles de notas en Obsidian, Notion o simplemente archivos Markdown, AnythingLLM te permite hacerles preguntas. No es solo buscar por palabra clave, es preguntar "¿qué conclusiones saqué sobre X en las notas de los últimos seis meses?" y obtener una respuesta que cruza documentos y sintetiza información.
Documentación técnica para desarrolladores: Puedes importar tu repositorio de código y preguntar cómo funciona un módulo específico, dónde está definida una función, o qué dependencias tiene un servicio. El equipo de Mintplex incluso publicó una demo específica sobre "Chat with your GitHub Code" que muestra este flujo.
Investigación y análisis de documentos: Si trabajas con PDFs largos (informes, papers, contratos), AnythingLLM te permite hacer preguntas concretas sin leerlos enteros. "¿Cuáles son las cláusulas de rescisión de este contrato?" o "¿Qué metodología usaron en este estudio?" son preguntas que puedes hacer directamente.
Empresas con requisitos de privacidad: El despliegue Docker permite tener una instancia multi-usuario en un servidor interno. Los documentos no salen de la infraestructura de la empresa. Con roles y permisos básicos (Admin, Manager, Default), puedes controlar quién accede a qué workspaces.
Lo que NO es: No es un sustituto de ChatGPT para tareas creativas generales. No es una herramienta de generación de imágenes. No es un CRM ni una suite de productividad. Es específicamente un sistema de chat con documentos y agentes, y en eso es muy bueno.
🚀 Cómo empezar a usarlo paso a paso
La instalación es más sencilla de lo que esperarías para una herramienta de este tipo. Hay dos caminos: Desktop (para uso personal) y Docker (para equipos).
Paso 1: Descargar e instalar. Vas a la página oficial y descargas el instalador para tu sistema operativo. Windows, Mac o Linux. El proceso es el de cualquier aplicación: ejecutas el instalador, siguiente, siguiente, terminar. No hay configuración de Python, no hay dependencias que resolver.
Paso 2: Configurar el modelo de lenguaje. Al abrir la aplicación por primera vez, te pide elegir un proveedor de LLM. Las opciones más comunes son OpenAI (necesitas API key), Anthropic, o un motor local como Ollama. Si no tienes Ollama instalado, AnythingLLM incluye su propio motor local que puedes usar desde el primer momento sin configurar nada más.
Paso 3: Crear un workspace. Cada workspace es un espacio aislado con sus propios documentos. Le pones un nombre, por ejemplo "Documentación del proyecto" o "Notas personales".
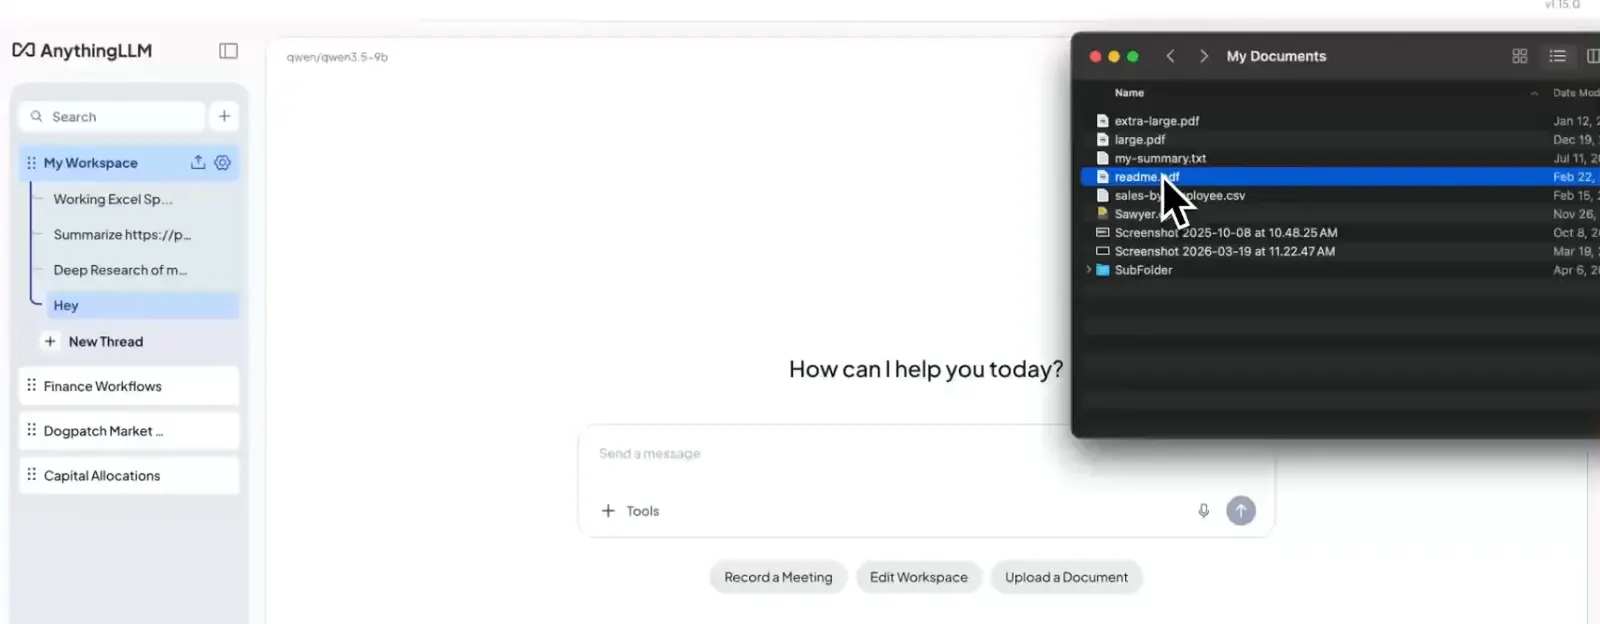
Paso 4: Subir documentos. Arrastras archivos al workspace o los seleccionas desde el explorador. AnythingLLM los procesa automáticamente. Puedes ver el progreso de la indexación en la interfaz.
Paso 5: Empezar a preguntar. Una vez indexados, haces preguntas en el chat. El sistema busca en los documentos, encuentra los fragmentos relevantes y genera una respuesta basada en ellos. Si usas Query Mode, solo responde con información de los documentos. Si usas Chat Mode, puede complementar con conocimiento general del modelo.
Paso 6 (opcional): Activar el agente. Si quieres que el asistente pueda usar herramientas (búsqueda web, scraping, etc.), activas el modo agente en la configuración del workspace. Luego usas @agent en tus mensajes para invocarlo.
💡 Trucos para sacarle el máximo partido
He cometido errores usando esta herramienta, y estos son los aprendizajes que comparto para que no los repitas:
- Empieza con Query Mode y umbral de similitud bajo. Si no encuentras información que sabes que está en tus documentos, el problema suele ser el umbral de similitud. Ve a configuración del workspace → Vector Database Settings y cambia el threshold a "No restriction". Luego ve subiéndolo si obtienes demasiado ruido.
- Usa el vocabulario de tus documentos. Si tus PDFs usan terminología técnica específica, formula tus preguntas con esos mismos términos. No preguntes "¿cómo empiezo la aplicación?" si el documento dice "¿cómo inicializar el servicio?". El sistema busca coincidencias semánticas, pero no es magia.
- Divide documentos grandes. AnythingLLM procesa los documentos en fragmentos. Si un PDF tiene 200 páginas, la información relevante puede quedar enterrada en fragmentos que no se recuperan bien. Para documentos muy largos, considera dividirlos en secciones más manejables.
- Ajusta el tamaño de los chunks si tienes problemas. En la configuración del workspace puedes controlar cómo se dividen los documentos. Chunks más pequeños mejoran la precisión pero pueden perder contexto. Chunks más grandes capturan más contexto pero pueden diluir la relevancia. El valor por defecto suele funcionar, pero si tu documentación es muy específica, merece la pena experimentar.
- Usa la memoria a tu favor. Si trabajas en un proyecto durante semanas, la memoria automática hace que el asistente recuerde el contexto de conversaciones anteriores. Puedes añadir memorias manualmente para información que quieras que siempre tenga presente.
- No expongas la versión Desktop a internet. La versión Desktop no tiene autenticación de usuarios. Si activas "network discovery" para conectar desde el móvil, asegúrate de que solo es accesible desde tu red local. Para uso multi-usuario, usa Docker.
📱 Dónde lo puedes usar
AnythingLLM tiene varias formas de despliegue, y la elección depende de si lo usas solo tú o si sois un equipo.
- Desktop (Windows, Mac, Linux): La forma más fácil. Instalación de un clic, sin configuración. Para uso personal, es la opción recomendada. Todo se ejecuta en tu máquina, sin cuentas ni servidores.
- Docker (self-hosted): Para equipos o para quien quiere acceder desde el navegador. Se instala en un servidor (puede ser tu propio PC con Docker, o un VPS). Soporta multi-usuario, roles, widgets embebidos. Es la opción para empresas que quieren una instancia compartida con control de acceso.
- Cloud (hosted): Mintplex Labs ofrece una versión gestionada en la nube, pero no soporta MCP ni agentes personalizados, y los precios empiezan en $50/mes. Para uso personal, no tiene mucho sentido cuando puedes usar Desktop gratis. Para empresas que no quieren gestionar infraestructura, puede ser una opción.
- iOS / Android: No hay aplicaciones móviles nativas. Puedes conectar desde el móvil al navegador de un despliegue Docker, pero no hay app.
- Extensión de navegador: Sí, hay una extensión oficial que permite enviar páginas web y texto seleccionado a un workspace de AnythingLLM. Útil para construir bases de conocimiento mientras navegas.
💰 Cuánto cuesta (y qué te dan gratis)
Este es uno de los puntos más claros de AnythingLLM: la versión Desktop y el self-hosted Docker son completamente gratis y open source bajo licencia MIT. No hay versión "premium" que desbloquee funciones en Desktop. Todo está ahí desde el primer momento.
Free (Desktop / Docker self-hosted): Todo incluido. RAG ilimitado en tus documentos, agentes, todas las integraciones de modelos, extensión de navegador, multi-usuario (solo Docker), embedded widgets (solo Docker). Sin límites de tokens, sin límites de documentos, sin cuentas que crear. Solo pagas lo que consumas si usas APIs de pago de OpenAI o Anthropic, pero eso es entre tú y esos proveedores.
Cloud Basic ($50/mes): Instancia gestionada en la nube, subdominio personalizado, hasta 3 miembros de equipo, menos de 100 documentos. No soporta MCP ni agentes personalizados.
Cloud Pro ($99/mes): Más capacidad, SLA de soporte de 72 horas.
Enterprise: Instalación on-premise, servicios gestionados, precios a consultar.
En la práctica, si eres un usuario individual o un equipo pequeño con conocimientos mínimos de Docker, la versión gratuita cubre todas tus necesidades. La nube es para quien no quiere gestionar nada y prefiere pagar por la comodidad.
🧑🎓 ¿Para quién es esto?
Para quien SÍ es:
- Desarrolladores y equipos técnicos: Especialmente si trabajan con código que necesitan consultar, o si tienen requisitos de privacidad que impiden usar servicios cloud.
- Investigadores y académicos: Personas que manejan grandes volúmenes de PDFs, papers y notas, y necesitan hacer preguntas transversales sin leerlo todo.
- Profesionales del conocimiento: Consultores, abogados, analistas que trabajan con documentación densa y necesitan extraer información rápidamente.
- Empresas con datos sensibles: Si no puedes subir tus documentos a la nube por política interna o regulación, AnythingLLM es una de las mejores opciones open source.
- Usuarios de Obsidian, Notion, Logseq: Cualquiera que tenga una base de conocimiento en Markdown y quiera convertirla en un sistema consultable con IA.
Para quien NO es:
- Quien busca un asistente generalista: Si tu uso principal es escribir, generar ideas o conversar sobre temas generales, ChatGPT o Claude son más directos y no requieren configuración.
- Quien no quiere configurar nada: Aunque Desktop es fácil, sigue siendo más pasos que abrir una web y escribir en un chat. Si no tienes paciencia para la configuración inicial, la nube gestionada de otros servicios puede ser mejor.
- Quien no tiene documentos propios: Si no tienes una base de documentos con la que trabajar, AnythingLLM pierde gran parte de su valor. Es una herramienta para consultar tu información, no para generar contenido desde cero.
- Equipos sin perfil técnico: El despliegue Docker requiere conocimientos básicos de terminal, Docker y configuración de red. Para equipos no técnicos, la versión Cloud o herramientas más sencillas pueden ser mejores.
🌍 Cuánta gente lo usa
AnythingLLM ha crecido de forma constante desde su lanzamiento. Los datos de tráfico estiman alrededor de 725.000 visitas mensuales en abril de 2026, con un ranking global en torno al puesto 73.000. Los principales países por tráfico son Estados Unidos (15%), China (12,7%), Francia (5,5%), Alemania (4,7%) y Rusia (4%).
El dato de China es interesante porque sugiere una adopción significativa en un mercado donde las alternativas locales son fuertes. El hecho de que sea open source y funcione localmente probablemente influye en esa adopción.
La actividad en GitHub sigue siendo alta, con releases regulares (la versión 1.8.5 llegó en agosto de 2025 y desde entonces han seguido publicando actualizaciones). El equipo mantiene un ritmo de desarrollo activo, con nuevas funciones como Model Router y Scheduled Jobs que llegaron en versiones recientes.
⚖️ Lo bueno y lo no tan bueno
Lo que me convence:
- La privacidad es real, no marketing. Todo se ejecuta en tu máquina. Los documentos, las conversaciones, las embeddings, nada sale de tu ordenador a menos que tú configures un modelo en la nube. Para quien trabaja con información sensible, esto no es un detalle menor.
- El Model Router es una solución inteligente al problema del coste. Puedes tener lo mejor de ambos mundos: privacidad y coste cero para consultas simples, potencia de modelos avanzados para lo que realmente importa. No he visto esta implementación en ninguna otra herramienta de forma tan accesible.
- La instalación Desktop es genuinamente fácil. Descargas, instalas, usas. Comparado con otras herramientas de RAG local que requieren configuración de Python y dependencias, esto es otro nivel de accesibilidad.
- El proyecto está activamente mantenido. Las actualizaciones son frecuentes, la comunidad es activa, y el equipo responde a los issues. No es un proyecto abandonado que prometía mucho y quedó en nada.
- La licencia MIT y el soporte multi-usuario en Docker. Para empresas, esto significa que pueden desplegar en su infraestructura sin coste de licencia, con control total sobre los datos.
Lo que no me convence:
- La documentación tiene lagunas. He tenido que buscar en issues de GitHub y foros para resolver dudas que deberían estar en los docs oficiales. Para una herramienta que aspira a ser accesible, la documentación podría ser más completa y clara.
- El despliegue Docker no es para principiantes. Aunque la documentación existe, configurar Docker, redes y volúmenes requiere conocimientos que no todo el mundo tiene. Para equipos sin perfil técnico, esto puede ser una barrera.
- La calidad del RAG depende mucho del modelo que uses. Con modelos pequeños o poco capaces, las respuestas pueden ser pobres. La herramienta no hace magia: si el modelo no es bueno, el resultado no será bueno.
- El soporte multi-usuario en Desktop no existe. Si quieres que varias personas usen la misma instancia, tienes que ir a Docker. Desktop es estrictamente para un solo usuario, sin autenticación ni roles.
🔍 Comparativa con alternativas
vs. OpenWebUI: OpenWebUI es otra interfaz popular para LLMs locales, especialmente cuando usas Ollama. Su punto fuerte es la extensibilidad y la comunidad de plugins. AnythingLLM tiene mejor soporte para RAG con documentos, agentes más desarrollados y una experiencia de escritorio más pulida. OpenWebUI es más un frontend de chat; AnythingLLM es una aplicación de conocimiento completa.
vs. PrivateGPT: PrivateGPT fue una de las primeras herramientas de RAG local, pero su interfaz es de línea de comandos. AnythingLLM es lo que PrivateGPT habría sido si tuviera una GUI decente. Para quien no se sienta cómodo con la terminal, AnythingLLM es la opción obvia.
vs. ChatGPT Plus: ChatGPT es más potente como modelo generalista y tiene funciones que AnythingLLM no tiene (generación de imágenes, análisis de datos avanzado). Pero ChatGPT no te permite ejecutar todo localmente, y si subes documentos, salen de tu control. AnythingLLM gana en privacidad y en control sobre tus datos. Para uso general, ChatGPT es más conveniente; para trabajo con documentos sensibles, AnythingLLM es superior.
vs. Dify / FastGPT: Estas son plataformas más orientadas a construir aplicaciones de IA para terceros. Tienen editores de flujo visual y están pensadas para despliegues más complejos. AnythingLLM es más sencillo y más directo para uso personal o de equipo interno. Si lo que quieres es construir un producto con IA, Dify o FastGPT pueden ser mejores. Si quieres consultar tus documentos, AnythingLLM es más apropiado.
🎯 Veredicto final: ¿Merece la pena?
Mi respuesta honesta: para quien encaja en su perfil, es una de las mejores herramientas gratuitas que puedes instalar en tu ordenador. Para quien no, es una complicación innecesaria.
Cuándo merece la pena: Tienes una base de documentos que consultas con frecuencia. Te preocupa la privacidad de tus datos y no quieres subirlos a la nube. Usas o quieres usar modelos locales pero no quieres pelearte con la línea de comandos. Tu equipo necesita una instancia compartida de chat con documentos en infraestructura propia. Eres desarrollador y quieres consultar tu código sin salir del editor.
Cuándo no: Solo necesitas un chatbot generalista para escribir o generar ideas. No tienes documentos propios con los que trabajar. No quieres dedicar tiempo a la configuración inicial. Eres usuario de Mac y quieres que todo sea "abrir y usar" sin ajustes. Tu equipo no tiene perfil técnico y no hay nadie que pueda gestionar un despliegue Docker.
AnythingLLM no es perfecto. La documentación puede mejorar, el despliegue Docker tiene curva, y la calidad del RAG depende del modelo que uses. Pero como herramienta gratuita y open source para convertir tus documentos en un sistema consultable con IA, no conozco nada que se le acerque en facilidad de uso y completitud. Si encajas en el perfil, la recomiendo sin reservas.
Comentarios