
🧰 Braintrust 到底是个什么东西
Braintrust 是一家总部在旧金山的 AI 基础设施公司,2023 年从隐身模式出来,创始人是 Ankur Goyal。这哥们之前是 Impira 的 CTO 和联合创始人,Impira 被 Figma 收购之后,他在 Figma 待了一段时间,后来出来做了 Braintrust。公司的核心团队基本都是从 Uber、Stripe、Figma 这些地方出来的,背景挺硬。
但这里要先把一个坑说清楚:Braintrust 有两个完全不同的东西。一个是 AI 开发者平台的 Braintrust,做的是 LLM 评估、监控、提示词管理和数据集管理,主要给工程团队用。另一个是同名的 Braintrust 人才网络,做的是去中心化的自由职业者匹配,跟 AI 开发工具八竿子打不着。本文说的是前者,就是那个给 AI 产品团队用的开发者平台。
Braintrust 的产品定位非常明确:帮 AI 工程团队把构建、评估、上线、监控这个循环跑通。它不帮你训练模型,也不帮你部署模型,它管的是模型外面那一圈东西。提示词改来改去到底有没有变好?这次上线的新版本会不会让回答质量下降?用户骂的那些回答到底错在哪?这些问题 Braintrust 想用一套工具链给你管起来。
⚙️ 核心功能有哪些
- LLM 评估:这是 Braintrust 的看家本领。你可以写测试用例,定义评分标准,然后批量跑模型输出,自动打分。支持代码打分、AI 打分、人工打分三种方式混着用。
- 提示词管理:在网页上直接改提示词、换模型、调参数,实时看输出变化,不用改代码重新部署。
- 数据集管理与版本控制:把生产环境里跑得好的、跑得差的对话都存下来,做成数据集,随时回放测试。数据集有版本,改了什么都记录在案。
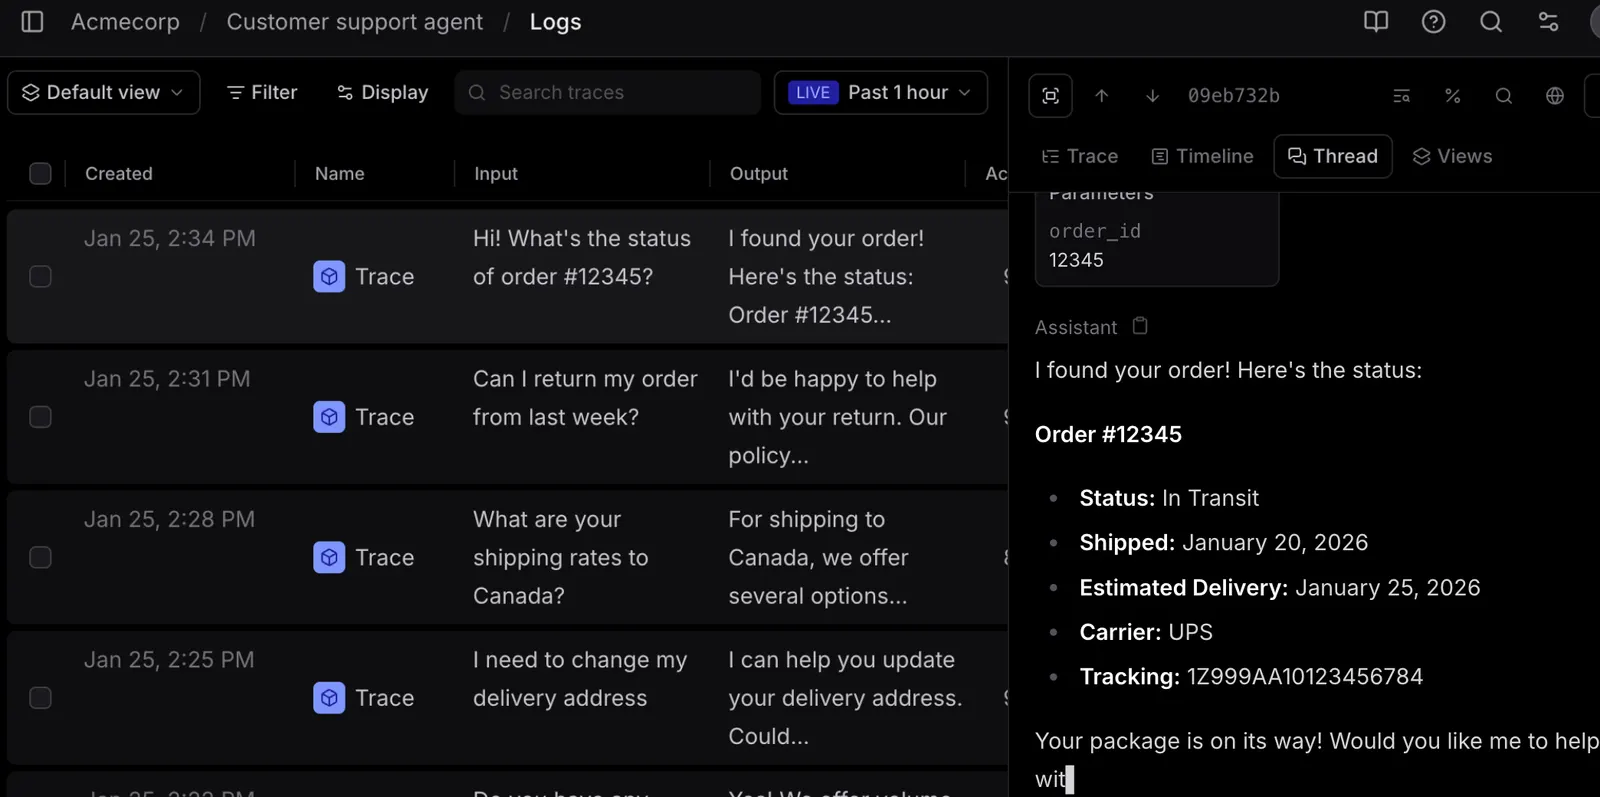
- 生产环境监控:上线之后能看到每一条请求的延迟、成本、token 用量、用户反馈。出了问题可以顺着 trace 往回查,看到底是提示词的问题还是模型的问题。
- 可观测性:如果你的 AI 应用是一条链,先检索再生成再后处理,Braintrust 能把整条链的每一步都记录清楚,哪个环节慢、哪个环节贵、哪个环节出错,一目了然。
- 自动评估库:开源的一个 Python 和 TypeScript 库,内置了一堆现成的打分器,比如事实一致性、答案相关性、SQL 正确性,拿来就能用,不用从零写评分逻辑。
- CI/CD 集成:可以把评估跑在 GitHub Actions 或者 CI 流水线里,每次改提示词或者换模型,自动跑一轮测试,分数掉了就拦住不让合并。
✨ 它和其他同类工具比,特别在哪
如果拿 Braintrust 和 LangSmith、Langfuse、Weights & Biases 这些比,最明显的差异是评估优先的设计哲学。LangSmith 更侧重可观测性和调试,Langfuse 开源生态好、自托管方便,W&B 是从传统机器学习实验追踪长过来的、功能大而全但有点重。Braintrust 的核心叙事从头到尾都是评估,它的整个产品架构是围绕怎么科学地衡量 AI 输出质量来搭的。
另一个特色是它不绑定框架。你用 LangChain 也好,用 LlamaIndex 也好,甚至纯手写 API 调用也好,Braintrust 都能接。LangSmith 和 LangChain 是同一家,用起来天然更顺,但如果你没用 LangChain,Braintrust 的通用性就体现出来了。
还有一点值得说:Braintrust 的自动评估库是开源的,你可以白嫖它的评分器,甚至只拿这个库在自己的代码里用,不碰它的 SaaS 平台。这个策略挺聪明的,降低了尝鲜门槛。
🎯 用它来做什么比较合适
最核心的场景是 AI 产品的质量保障。比如你在做一个 RAG 客服机器人,改了检索策略之后,怎么知道回答质量是变好了还是变差了?Braintrust 让你把历史对话跑一遍,自动打分,用数据说话,而不是靠感觉。
提示词工程师用 Braintrust 会很舒服。在 Playground 里快速迭代提示词,改一版存一版,每一版都自动跑评估对比,哪版好哪版差清清楚楚。比在代码里改、部署、手动测试要快得多。
需要做模型选型的团队也适合。同一个任务,GPT-4o、Claude、Gemini 各跑一遍,用同一套评估标准打分,成本、延迟、质量三个维度放一起比,选型决策就有依据了。
不太适合的场景:如果你只是偶尔调一下 API 写点东西,没有任何工程化的需求,Braintrust 对你来说太重了。它是个给团队用的工具,不是给个人玩的。
🚀 怎么开始用
注册很简单,GitHub 账号或者邮箱都行。新用户会拿到一笔初始额度,够你跑一些实验。Braintrust 有免费层,个人开发者和小项目用起来没有压力。
实际操作的路径大概是:安装 SDK,拿 API Key,在代码里包一层 Braintrust 的 logger,跑你的 AI 应用,去后台看数据。Python 和 TypeScript 都有官方 SDK,几行代码就能接入。
如果你只想试试评估功能,可以先用 Playground。在网页上写一个提示词,选个模型,然后手动或者批量输入测试用例,看输出结果。觉得有意思了,再把评估逻辑搬到代码里,用 Eval 函数跑自动化测试。
提示词管理的流程是:在 Playground 里调好一版提示词,保存,在代码里用 load_prompt 拉下来用。以后改提示词直接在网页上改,代码不用动。
💡 几个让 Braintrust 用得更顺的技巧
先别追求大而全的评估集。刚开始跑评估的时候,别想着把几百个测试用例一次性写完。先从 20 到 30 个最有代表性的场景开始,把评估流程跑通,再慢慢扩充。很多团队卡在数据集还没准备好这一步,结果永远没开始。
用现成的自动评估器打底,再写自定义评分器。事实一致性、相关性这些通用维度,开源库里都有现成的,直接调就行。真正需要你花时间的,是那些业务特有的判断标准,比如这个回答有没有提到退货政策、SQL 有没有用到正确的表。
把评估跑进 CI 里。Braintrust 的评估可以集成到 GitHub Actions,每次 PR 改动了提示词或者模型配置,自动跑一轮。分数掉了就拦住。这个习惯一旦养成,你就不会再有上线之后才发现变差了的事故。
生产环境的数据要往回喂。Braintrust 支持把生产环境的 trace 导回数据集。用户骂的那些回答、人工客服纠正过的对话,都是最宝贵的测试用例。别浪费了。
成本评估别忽略。Braintrust 的 trace 里会记录每次调用的 token 消耗和成本。评估的时候别只看质量分,也看看成本分。有时候质量只降了 2%,但成本降了 60%,这种取舍是要用数据来做的。
📱 在哪里能用
Braintrust 的核心使用界面是 Web 控制台,浏览器打开就能用,Chrome、Edge、Safari 都支持。开发工作主要靠 Python 和 TypeScript SDK,通过 pip 或者 npm 安装,支持 macOS、Linux、Windows。
没有官方的桌面客户端,没有 iOS 或 Android 应用,也没有浏览器插件。Braintrust 本质上是一个开发者工具,它的使用场景是在 IDE 和终端里,不是在手机上。
SDK 安装方式:Python 用 pip install braintrust,TypeScript 用 npm install braintrust。自动评估库是单独的包,Python 用 pip install autoevals,TypeScript 用 npm install autoevals。
💰 收费情况
Braintrust 的定价分三档,个人开发者和小团队用起来比较友好。
免费档:每月 100 万条日志,2 个用户,1 个组织。够个人开发者和小项目跑通评估流程,长期用也没问题,只要你的量不大。
Pro 档 249 美元每月:每月 500 万条日志,无限制用户,支持 SSO,更长的数据保留期。适合正经在做 AI 产品的团队。
企业档:需要联系销售,支持自托管,可以部署在 VPC 内部,自定义数据保留策略,SOC 2 合规报告,专属支持。金融医疗这类对数据位置有要求的客户会选这档。
需要说明的是,Braintrust 的日志量是按 trace 算的,不是按 token。如果你跑一个复杂的链,一个用户请求可能产生多条 trace,实际用量会比表面上看起来多。评估跑的测试用例也算日志量,所以做大规模评估的时候要注意量。
👥 谁适合用,谁不适合
适合的人:正在构建 AI 产品、需要对输出质量做系统化管理的工程团队;被提示词迭代折磨、每次改完都不知道是变好还是变差的开发者;需要做模型选型、要拿数据说话的技术负责人;做 RAG 系统、需要监控检索质量的数据团队。
不太适合的人:只是调 API 写点内容的普通用户;没有工程能力、不想写代码的人;预算极其有限的个人开发者,免费档够用但量有限;不需要评估、只需要简单日志的极简场景。
🌍 全球使用情况
Braintrust 的客户名单挺有说服力:Notion、Stripe、Airtable、Instacart、Zapier、Coda、Ramp 这些公司都在用。2024 年完成了 3600 万美元的 A 轮融资,由 a16z 领投,Elad Gil 和 Basecase 跟投。更早之前还有 Greylock、Elad Gil 等人的种子轮。
用户主要集中在北美,欧洲也有不少 SaaS 公司在用。具体的月活或用户规模没有公开数据,但从客户名单和融资节奏来看,它在 AI 开发者工具这个细分市场里已经站稳了脚跟。它的开源自动评估库在 GitHub 上有一定关注度,Python 和 TypeScript 版本都有。
⚖️ 优缺点说清楚
优点:评估能力是同类工具里最深入的,不是简单打个分,而是有一套完整的评估方法论;不绑定框架,LangChain、LlamaIndex、纯 API 调用都能接;Playground 做得顺手,改提示词不用碰代码;自动评估库开源,降低了尝鲜门槛;免费档给得比较大方,个人开发者能长期用。
缺点:学习曲线不低,评估的概念比如数据集、评分器、实验对比需要时间理解,不是开箱即用的东西;日志量计费方式需要适应,trace 数量和 token 数量是两个维度,容易低估成本;没有自托管选项在低档位,有数据合规要求的团队必须上企业档,价格不透明;生态集成不如 LangSmith 丰富,毕竟 LangChain 的体量摆在那里。
🔍 和同类工具比一比
对比 LangSmith:LangSmith 和 LangChain 深度绑定,用 LangChain 的团队集成更丝滑,可观测性功能也很强。Braintrust 的优势在于评估的深度和框架无关性。如果你没用 LangChain,Braintrust 的通用性更好。
对比 Langfuse:Langfuse 是开源可自托管的,免费版给得很慷慨,适合想自己掌控数据的小团队。Braintrust 的评估工具链更成熟,Playground 体验更好,但自托管要上企业档。
对比 Weights & Biases:W&B 是从传统机器学习实验追踪长过来的,功能更全面,但 AI 应用评估这块没有 Braintrust 专注。W&B 的定位是机器学习全流程,Braintrust 的定位是 LLM 质量保障。
选型建议:如果你重度使用 LangChain,先试 LangSmith;如果你想开源自托管,看 Langfuse;如果你最在乎评估的深度和科学性,Braintrust 是更对的选择。
📌 最后的结论
Braintrust 是个给认真做 AI 产品的人准备的评估工具。它不帮你做花哨的功能,核心就一件事:让 AI 输出的质量变得可衡量、可对比、可追踪。如果你在跑一个 AI 产品,已经开始被改了提示词之后到底变好了还是变差了这个问题困扰,Braintrust 值得花一个下午试试它的免费档。
但如果你还没到需要系统化评估的阶段,或者你的 AI 应用还在非常早期的原型状态,Braintrust 对你来说可能有点早。先把产品跑起来,等质量问题开始咬你了再回来。
一句话:把它当 AI 产品的质量管理系统来用,别当开发框架来期待。
评论