
🔥 工具概览:Fireworks AI 是什么
Fireworks AI 是一家专注于 AI 推理和模型训练的基础设施平台,由前 Meta PyTorch 核心开发者 Lin Qiao(乔琳)于 2022 年在加州红木城创立。Lin Qiao 是复旦大学计算机系校友,在 Meta 期间深度参与了 PyTorch 框架的构建。公司成立的时间点很有意思,比 ChatGPT 发布还早了一个月。
它的定位不是训练前沿大模型,也不是做面向消费者的 AI 应用,而是帮企业把开源模型微调好、托管好,然后按调用量收钱。黄仁勋在 GTC 大会上跟 Lin Qiao 对谈时,直接说 Fireworks 是 AI 工厂的台积电。
产品核心是一套兼容 OpenAI API 的推理云平台。开发者通过一个 API key,就能调用平台上 100 多个开源模型,覆盖文本、图像、音频、多模态等类型。企业可以在自己的专有数据上做微调,支持 SFT、DPO 和 RFT,还能同时挂上多个 LoRA 适配器。
2026 年 7 月,Fireworks 完成了 15.05 亿美元的 D 轮融资,投后估值 175 亿美元。ARR 突破 10 亿美元,平台每天处理的 token 超过 40 万亿,服务超过 1 万家企业客户。
⚙️ 核心功能:10 个你会实际用到的能力
- Serverless 推理:热门模型无需部署,直接按 token 付费调用。适合做快速测试和原型验证。
- 专用部署:把模型部署到专属 GPU 上,性能和可用性有保障。支持自动扩缩容,冷启动时间短。按 GPU 秒计费。
- 模型微调:支持 SFT、DPO 和 RFT,可以训练从 8B 到 1T+ 参数规模的模型。
- Multi-LoRA 服务:一个基础模型上可以同时挂载最多 100 个 LoRA 适配器,不额外加价。对需要同时服务多个定制模型的企业来说很实用。
- FireAttention 推理引擎:自研的 CUDA 内核栈,官方宣称在相同配置下比 vLLM 延迟低 4 倍。这是 Fireworks 速度故事的技术底座。
- Function Calling 和结构化输出:支持让模型调用外部工具,也支持 JSON schema 约束输出,适合做 Agent 和自动化工作流。
- Responses API:兼容 OpenAI Responses API 格式,支持对话状态存储、流式输出、MCP 服务器集成。Pro 以上用户可以直接用。
- FireRouter:自动路由层,根据每轮对话的内容选择最合适的模型。适合不想自己维护模型选择逻辑的开发者。
- 训练 SDK:提供三种训练界面:Training Agent(描述任务即可)、Managed Training(配置式)、Bring-Your-Own(自己写训练循环)。每一档部署到生产都是秒级。
- 批量推理:非交互式的异步推理任务,价格是 serverless 的 50%。适合跑数据集评估、离线生成等场景。
✨ 它跟同类工具比,特别在哪
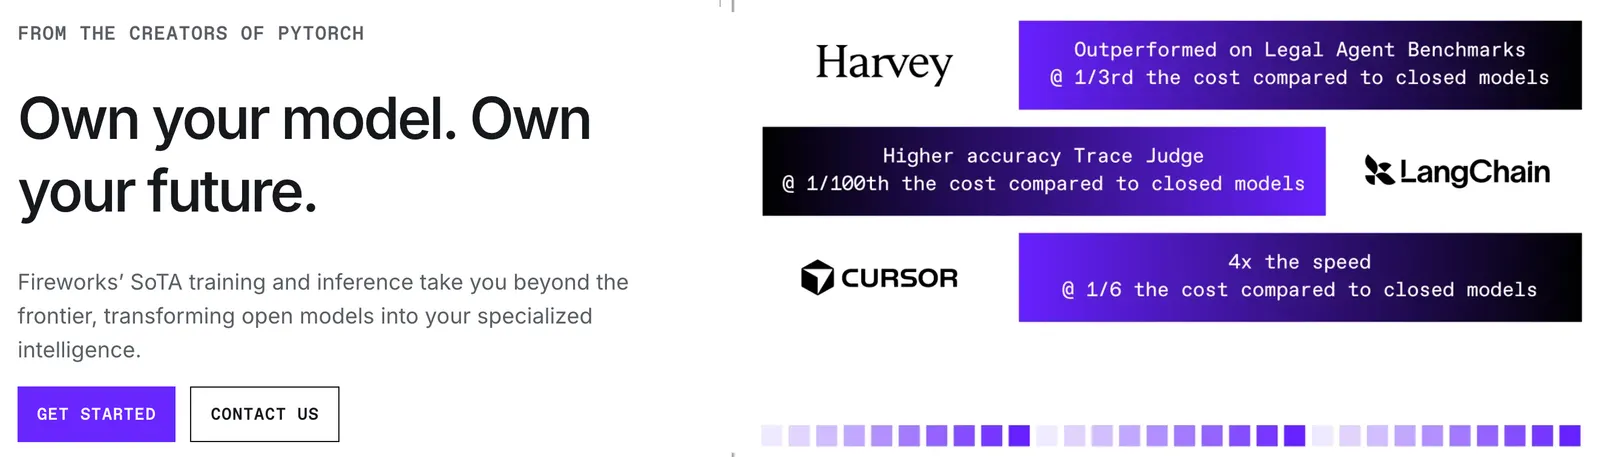
Fireworks 最核心的差异化是延迟优化。在推理平台里,Together 拼的是模型目录广度,Baseten 拼企业级打磨,Modal 拼 Python 原生体验。Fireworks 的选择是:把延迟做到最低。它的 FireAttention 引擎不是随便调调 vLLM,而是自己写的 CUDA 内核栈,官方宣称比 vLLM 快 4 倍。对于需要实时响应的应用(比如 Cursor 的代码补全、Notion 的 AI 功能),这个延迟差异是能直接感受到的。
第二个差异点是微调模型按基础模型价格收费。很多推理平台会对你部署的 LoRA 或微调模型加价,Fireworks 的策略是微调模型和基础模型同价。这意味着你花同样的钱,可以用自己定制过的模型,质量更高但成本不变。
第三个差异点是训练和推理的统一。Fireworks 的推理平台本身已经在大规模服务 Cursor、Vercel、Notion 等客户,训练基础设施直接构建在同一个平台上。官方会公布训练和推理之间的 KL 散度(所有值低于 0.01),用来证明训练出来的模型跟推理时跑的是同一个东西。
但要客观说,Fireworks 的定价不算便宜。GPU 租赁在 2026 年 5 月涨到了 $1/小时。对于持续利用率超过 30% 的工作负载,按 GPU 分钟计费反而比按 token 计费更划算。
🏢 适合哪些实际工作场景
AI 应用开发团队:需要把开源模型快速集成到产品里的团队。Fireworks 的 OpenAI 兼容 API 让迁移成本很低,把 base_url 换成 Fireworks 的地址就行。
需要定制模型的企业:有私有数据,想训练一个懂自己业务的模型。Fireworks 的微调能力和 Multi-LoRA 服务让企业可以用自己的数据训练,同时服务多个定制版本。
延迟敏感的应用:代码补全、实时对话、Agent 工作流等场景。Cursor 的 Composer、Vercel 的 v0、Notion 的 AI 功能都在用 Fireworks 做推理。
需要 RL 训练的团队:Fireworks 的 RFT 支持让团队可以定义 reward function 而不是准备大量标注数据。rLLM 团队用它来做自主 AI 研究。
不太适合的场景:纯探索性、用量极低的个人开发者。Fireworks 的定价体系更适合有一定规模的生产工作负载,如果只是偶尔调用几次,Together 或 Replicate 的免费额度可能更友好。需要最新闭源模型的场景:Fireworks 主要托管开源模型,如果你必须用 GPT-5 或 Claude Opus,它帮不上忙。
🚀 怎么用起来:从注册到第一个 API 调用
第一步:注册并获取 API Key。访问 fireworks.ai,用邮箱注册。登录后在控制台生成一个 API key,格式是 fw_...。
第二步:选择模型。在文档的模型页面浏览可用模型。Serverless 模型可以直接用,比如 accounts/fireworks/models/glm-5p3-flash。想用自定义微调模型的话需要创建专用部署。
第三步:调用 API。因为兼容 OpenAI 格式,直接把 base_url 改成 https://api.fireworks.ai/inference/v1,model 改成 Fireworks 的模型 ID 就行。Python、JavaScript、cURL 都有示例。
第四步:进阶功能。需要结构化输出就加 response_format 参数;需要模型调用工具就加 tools 参数;需要推理过程就设 reasoning_effort。Responses API 还支持对话状态存储和 MCP 服务器集成。
💡 让使用更顺手的几个实用技巧
先用 Serverless 做原型,再决定要不要专用部署。Serverless 按 token 付费,适合验证阶段。一旦你确定了模型和用量,再考虑专用部署。判断标准大概是:如果你对某个 GPU 的持续利用率超过 30%,按 GPU 秒计费会比按 token 便宜。
提示缓存能省钱。Fireworks 对缓存命中的输入 token 收费极低,比如 DeepSeek V4 Flash 缓存输入只要 $0.006/百万 token,正常输入是 $0.30/百万。如果你的应用有重复的系统提示词或上下文,确保它们被缓存。
微调模型和基础模型同价,放心用 LoRA。很多平台会对 LoRA 加价,Fireworks 不加。如果你有多个业务场景,给每个场景训一个 LoRA 挂在同一个基础模型上,成本跟只用基础模型一样。
批量任务走 Batch 通道。不需要实时返回的任务(数据集评估、批量生成)用 Batch 推理,价格直接打五折。代码上就是加个参数的区别。
📱 怎么安装:纯云端,无本地安装
Fireworks AI 是一个纯云端平台,没有桌面客户端或手机 App。你唯一需要的是网络连接和一个 API key。
不过 Fireworks 提供了 FireConnect 命令行工具,用来把 Fireworks 的模型接入你常用的编码工具。支持 Claude Code、Codex CLI、Cursor、VS Code、OpenCode 等工具。安装方式是跑一行 shell 脚本,然后 fireconnect login 登录,再 fireconnect cursor(或对应工具名)连接。
如果你用 LLM 网关(比如 Portkey、LiteLLM),Fireworks 的模型可以直接配置进去。LiteLLM 的配置示例在文档里有。
💰 收费情况:按用量预付费
Fireworks 采用预付费模式:你购买 credits,然后根据实际用量扣费。计费维度分三种:Serverless 按 token、专用部署按 GPU 秒、Managed Training 按训练 token。
Serverless 价格方面,8B 级别模型大约 $0.2/百万 token 起步,70B 级别约 $0.9/百万 token。具体模型定价有差异:DeepSeek V4.1 Flash 输入 $0.30/百万、输出 $1.20/百万;GLM 5.3 Flash 输入 $0.15/百万、输出 $0.50/百万;NVIDIA Nemotron 3.5 Lightning 30B 输入只要 $0.05/百万。
批量推理是 Serverless 价格的 50%。专用部署的 GPU 租赁价格在 2026 年 5 月调整到了 $1/小时。
对企业客户,Fireworks 提供后付费选项,需要联系销售团队。
👥 谁适合用 Fireworks AI
AI 应用开发者:需要把开源模型集成到产品里,对延迟敏感,想用 OpenAI 兼容 API 降低迁移成本。Cursor、Notion、Vercel 的案例证明了它的生产可用性。
有私有数据的企业:想训练自己的定制模型,但不想自己管 GPU 集群和训练基础设施。Fireworks 的 Training Agent 让描述任务到部署模型变成可能。
需要 RL 和高级微调的 ML 团队:提供从 SFT 到 RFT 的完整训练工具链,支持全参数训练到 1T 参数规模。
不太适合的:只是偶尔玩玩 AI 的个人用户——Fireworks 的定价和定位都面向生产工作负载;必须使用闭源模型的团队——Fireworks 主要托管开源模型。
🌍 全球使用情况
Fireworks 的增长速度在 AI 基础设施领域比较突出。2025 年 10 月 C 轮时,公司估值 40 亿美元,ARR 约 2.8 亿美元,服务超过 1 万家企业客户。到 2026 年 7 月 D 轮,估值涨到 175 亿美元,ARR 突破 10 亿美元,日处理 token 从 15 万亿涨到 40 万亿以上。
客户包括三星、Uber、DoorDash、Notion、Shopify、Upwork、Cursor、Perplexity、Vercel、Sourcegraph、UiPath 等。其中约 70% 是英伟达云服务覆盖不到的中小企业。
根据 Ramp 的采购数据,2026 年 8 月有 15% 的模型服务与推理类别的组织在使用 Fireworks,比前一年上升了 4 个百分点,在同类平台中排名第 4。主要用户群体是中型市场公司,采用率约 16%。
⚖️ 真实优缺点
优点:
- 延迟优化是实打实的。FireAttention 自研引擎在实时应用场景下比通用方案快得多,Cursor 和 Vercel 的选择说明了这一点。
- 微调模型不加价。LoRA 和微调模型按基础模型价格收费,企业可以放心用私有数据定制。
- 训练和推理统一平台。不会出现训练环境跑得好、推理环境跑不动的情况,官方公布 KL 散度来证明一致性。
- OpenAI 兼容 API,迁移成本低。把 base_url 一换就能用,不用重写应用逻辑。
缺点:
- 定价不算便宜,GPU 租赁在 2026 年 5 月涨到了 $1/小时,对持续利用率高的场景不一定是最优选择。
- 按 token 计费对非交互式、可预测的工作负载不划算。超过 30% 持续利用率后,按 GPU 分钟计费的平台更有优势。
- 只托管开源模型。如果你需要 GPT-5 或 Claude Opus 的特定能力,Fireworks 提供不了。
- 对个人开发者的免费额度不如 Together 或 Replicate 友好,起步门槛偏向有实际用量的团队。
🆚 跟同类工具怎么选
Fireworks vs Together AI:Together 拼的是模型目录广度,200+ 模型,新开源模型几天内就上。Fireworks 拼的是延迟和微调性价比。如果你要什么模型都有,Together 更合适;如果你要跑得快、能用自己的定制模型,Fireworks 更对口。
Fireworks vs Baseten:Baseten 的企业级打磨更成熟,按 GPU 分钟计费,适合利用率高且稳定的工作负载。Fireworks 按 token 计费,适合突发性的流量。利用率超过 30% 时 Baseten 可能更便宜。
Fireworks vs 硅基流动:国内团队如果主要服务国内用户,硅基流动在合规和网络延迟上更有优势。Fireworks 的强项在训练和推理的统一,以及跟海外主流开发工具的集成。
简单选法:延迟敏感加需要微调选 Fireworks,模型目录广度优先选 Together,GPU 利用率高选 Baseten。
📌 总结:值不值得用
Fireworks AI 是一个定位非常清晰的产品:它不跟前沿模型实验室竞争,而是做让开源模型在生产环境里跑得又快又便宜这件事。它的技术壁垒在 FireAttention 引擎和训练-推理统一的工程能力上,商业模式在微调不加价和 OpenAI 兼容 API 上。
值得用的情况:你在开发一个对延迟敏感的 AI 应用,需要生产级的推理服务;你有私有数据想训练定制模型,但不想自己管基础设施;你已经在用开源模型,想从其他推理平台迁移过来,Fireworks 的 OpenAI 兼容 API 让迁移成本很低。Cursor、Notion、Vercel 的生产案例是可信的参考。
不值得用的情况:你只是偶尔调用 AI API 的个人开发者,Fireworks 的定价和定位面向有实际用量的团队;你的工作负载持续利用率很高且可预测,按 GPU 分钟计费的平台可能更划算;你需要闭源模型的特定能力,Fireworks 只托管开源模型。
一句话总结:如果你在找一个跑得快、能定制、价格透明的开源模型推理平台,Fireworks 是目前最值得认真评估的选择之一。
评论