
⚡Basetenとは?AIモデルを本番環境で動かすためのAIインフラ
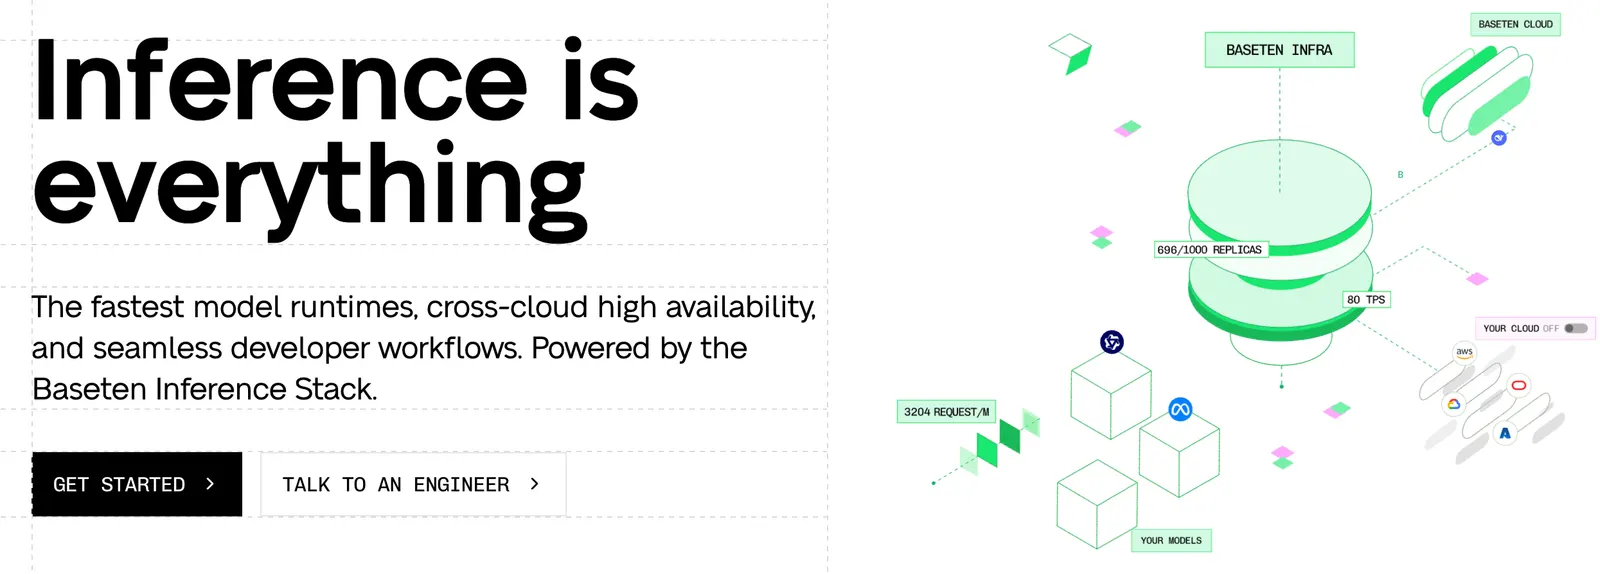
Basetenは、AIモデルを本番環境へデプロイし、高速かつ安定した推論処理を行うためのAIインフラプラットフォームです。ChatGPTやClaudeのように一般ユーザーが直接AIへ質問するサービスではなく、AIサービスを開発する企業やエンジニアが利用する開発者向けの基盤と考えると分かりやすいでしょう。
Basetenの役割は、AIモデルを「作る」ことだけではありません。完成したモデルをAPIとして公開し、ユーザーからの大量のリクエストを処理しながら、レイテンシー、GPUコスト、スケーリング、モデル管理などを効率よく運用できる環境を提供しています。
Basetenは2019年に創業されたAIインフラ企業です。現在はAI推論を中心に、モデルのデプロイ、最適化、GPUコンピュート、トレーニング、セルフホスト、企業向けセキュリティなどへサービス領域を広げています。
Basetenは「AIを使うためのチャットサービス」ではなく、「自分たちのAIモデルをユーザーへ提供するためのインフラ」です。
| 項目 | 内容 |
|---|---|
| サービス名 | Baseten |
| 創業 | 2019年 |
| カテゴリー | AI Inference Platform / AIインフラ |
| 主な用途 | AIモデルのデプロイ、推論、API提供、スケーリング、最適化 |
| 主な対象 | AIスタートアップ、MLエンジニア、企業の開発チーム |
🧩Basetenの主な機能
1. AIモデルの本番デプロイ
Basetenの中心的な機能が、AIモデルの本番環境へのデプロイです。オープンソースモデル、自社で開発したモデル、ファインチューニングしたモデルなどを、実際のWebサービスやアプリケーションから利用できる状態へ持っていけます。
モデルそのものを開発する工程と、ユーザーへ提供するためのインフラ構築を分けられるため、AIプロダクトの開発スピードを上げやすいのが特徴です。
2. 高速なAI推論
AIサービスでは、モデルの精度だけでなく「何秒で結果が返ってくるか」がユーザー体験を左右します。BasetenはモデルランタイムやGPUの利用方法などを最適化し、低レイテンシーと高スループットを意識した推論環境を提供しています。
3. オートスケーリング
AIサービスでは、アクセス数が時間帯によって大きく変わります。Basetenではリクエスト量に応じてコンピュートをスケールさせる仕組みを利用できるため、アクセスが増えたときの処理能力を確保しやすくなっています。
反対に、利用量が少ない時間帯まで大量のGPUを固定して動かし続けるといった無駄も抑えやすくなります。
4. 最適化済みAIモデルのAPI
自分でモデルを一からデプロイするだけでなく、Baseten側で準備されたモデルをAPIとして利用する方法もあります。
LLMなどを比較したいときや、まずAI機能のプロトタイプを作りたいときには、この方式が便利です。モデルのセットアップやGPU環境の構築にかかる時間を減らせます。
5. Trussによるモデルパッケージング
Basetenでは、オープンソースのモデルサービングツールであるTrussを利用できます。モデルと必要な依存関係をまとめ、クラウド環境へ持ち込んで動かすための仕組みです。
既存のAI開発環境からBasetenへ移行するときにも、この仕組みが役立ちます。
6. AIモデルのトレーニング
Basetenは推論だけでなく、AIモデルのトレーニングやファインチューニングを行うためのコンピュート環境にも領域を広げています。
モデルを学習し、そのモデルを本番推論へ移すという一連の流れを、より近い環境で管理できるようになっている点は、AI開発チームにとって扱いやすい部分です。
7. セルフホスト・ハイブリッド構成
企業向けには、Basetenのインフラをそのままクラウドサービスとして利用するだけでなく、自社クラウド環境やVPCを活用した構成も選択できます。
企業データをできるだけ自社環境に置きたい場合や、既存のクラウドインフラを活用したい場合に検討しやすい機能です。
8. API管理・モデル配信
AIモデルをAPIとして提供するための仕組みもBasetenの重要な領域です。特にAIモデルを自社サービスとして販売する企業にとって、モデルそのものだけでなく、APIの利用量やアクセスを管理できることには大きな意味があります。
🔍Basetenの大きな特徴は「GPU」より「AI推論の運用」
Basetenを単純なGPUレンタルサービスとして見ると、このサービスの特徴をつかみにくくなります。
もちろんGPUコンピュートは重要ですが、Basetenが力を入れているのは、そのGPU上でAIモデルを本番サービスとして安定して動かすことです。
AIモデルを作った後に発生する問題を解決する
AIモデルが開発環境で動いたとしても、それだけでサービスが完成するわけではありません。
実際のサービスでは、同時アクセスが増えたときの処理、GPUコスト、応答速度、モデルの起動時間、障害対策、セキュリティなど、研究開発とは別の問題が出てきます。
Basetenは、この「モデル開発と商用サービスの間」にある面倒なインフラ部分をまとめて扱うことを目指しています。
性能とコストの両方を見る設計
AI推論では、単純に高性能なGPUを使えばいいというわけではありません。モデルのサイズ、入力データ、出力トークン数、同時実行数によって最適な構成は変わります。
Basetenでは推論速度だけでなく、GPUの利用効率やスケーリングも含めて最適化できるため、本番AIサービスとの相性が良い設計です。
AIスタートアップとの相性が良い
AIスタートアップの場合、少人数のチームでモデル開発、プロダクト開発、インフラ構築をすべて行う必要があります。
その中でAIインフラを一から構築すると、モデル開発そのものに使える時間が減ってしまいます。Basetenのようなサービスを使えば、インフラ部分をある程度まとめて管理できます。
💻Basetenの実際の使用シーン
AIチャットサービス
独自LLMやオープンソースLLMを使ったAIチャットサービスのバックエンドとして利用できます。自社アプリからAPIを呼び出し、ユーザーの質問をモデルへ送る構成です。
AIエージェント
AIエージェントの頭脳となるLLMを高速に推論させる用途にも利用できます。特にユーザーからのリクエストが多いサービスでは、推論インフラの安定性が重要になります。
画像生成サービス
画像生成モデルをAPI化して、Webサービスやアプリケーションから利用するケースにも向いています。自社の画像生成サービスを作る場合、モデルの推論処理をBaseten側へ切り分けられます。
音声認識・文字起こし
音声認識モデルを使った文字起こしサービスや、音声データをAIで処理するバックエンドにも利用できます。
音声AI・ボイスエージェント
音声生成や音声認識を組み合わせたAI電話、音声アシスタント、リアルタイム会話システムなどでも推論インフラが必要になります。
RAG・AI検索
社内文書検索やRAGサービスでは、EmbeddingモデルやLLMを組み合わせることがあります。Basetenを推論部分に利用することで、AI検索システムのバックエンドを構築できます。
AIコーディングサービス
コード生成モデルを自社の開発支援サービスへ組み込む場合にも利用できます。コード生成ではユーザーが短時間に大量のリクエストを送ることがあるため、推論速度と安定性が重要です。
AIスタートアップのプロダクト基盤
独自AIを中心にしたSaaSを開発している企業では、BasetenをAIモデルの実行基盤として利用できます。モデル開発とインフラ運用を分離できるため、少人数チームでも本番サービスへ移行しやすくなります。
一方、文章を書いたり画像を生成したりするだけの一般ユーザーにとっては、Basetenを直接使う必要はほとんどありません。
🛠️Basetenの使い方:登録からモデル公開まで
STEP 1:アカウントを作成
まずBasetenでアカウントを作成します。開発環境からAIモデルをデプロイするための管理画面へアクセスできるようになります。
STEP 2:利用するモデルを決める
最初に決めるのは「自分のモデルを使うのか」「既存のモデルAPIを使うのか」です。
すぐにAI機能を試したい場合は、提供されているモデルAPIから始める方法があります。独自モデルを持っている場合は、Trussなどを利用してモデルをBasetenへ持ち込みます。
STEP 3:モデルを設定する
モデルに必要なライブラリ、環境変数、GPU、起動方法などを設定します。
ここは一般的なAIチャットサービスとは大きく違う部分です。ある程度の開発知識が必要になります。
STEP 4:モデルをデプロイ
設定したモデルをBasetenへデプロイします。まず開発用環境で正常に動作するかを確認し、その後、本番用の環境へ移行します。
STEP 5:APIから呼び出す
デプロイしたモデルはAPI経由で利用できます。例えば、自社のWebアプリからユーザーの入力を送信し、Baseten上のLLMから生成結果を受け取るという構成です。
STEP 6:速度とコストを確認
実際のリクエストを送って、レスポンス時間、GPU使用量、同時実行数などを確認します。
STEP 7:スケーリングを設定
アクセス量が増えたときに必要なコンピュートを確保できるよう、オートスケーリングなどを設定します。
STEP 8:本番環境へ公開
テストが完了したら本番環境へ移行します。ここからBaseten上のモデルを自社サービスのバックエンドとして利用できます。
🧠Basetenを上手に使うためのポイント
最初に「何を作るのか」を明確にする
Basetenは自由度が高い分、目的が曖昧な状態で触ると設定項目が多く感じられます。
「社内文書検索を作る」「画像生成APIを提供する」「LLMチャットを本番化する」など、最初にサービスの目的を決めておくと、必要なモデルやGPU構成を選びやすくなります。
モデルの精度と推論速度を分けて評価する
AIサービスでは「一番賢いモデル」を使えば必ずしも良い結果になるわけではありません。
ユーザーが待てる時間、APIの利用量、1リクエストあたりのコストまで含めてモデルを選ぶ必要があります。
最初から大きなGPU構成にしない
開発初期から高価なGPUを大量に確保すると、まだユーザーが少ない段階でコストだけが増えてしまいます。
まず小さな構成でモデルを動かし、実際のトラフィックを確認してからGPUやインスタンス数を増やす方法が現実的です。
レスポンス速度を数値で確認する
「なんとなく速い」ではなく、平均レイテンシー、ピーク時のレイテンシー、同時リクエスト数などを測定します。
特にAIチャットや音声AIでは、数秒の違いがユーザー体験に直結します。
APIコストを早い段階から計算する
AIサービスはユーザー数が増えるほど推論コストも増えます。開発時点から「1ユーザーあたり月に何回AIを使うか」「1回あたりどれくらいのトークンを消費するか」を計算しておくと、後から料金に驚きにくくなります。
🔐Basetenのセキュリティと企業利用
AIを企業システムへ組み込む場合、モデルの速度だけでなくデータ管理も重要です。
Basetenは企業利用を想定したセキュリティ機能を提供しており、SOC 2 Type II、GDPR、HIPAA対応などを含む企業向けのセキュリティ要件を意識した構成が用意されています。
また、企業向けにはセルフホストやハイブリッド構成などの選択肢もあります。自社のクラウド環境やVPCを活用したい企業にとっては、この柔軟性が導入判断のポイントになります。
ただし、企業で利用する場合は「Basetenだから安全」とだけ判断するのではなく、自社のデータ分類、保存場所、アクセス権限、ログ管理、契約条件などを確認したうえで導入することが重要です。
💻Basetenのインストール方法・対応環境
BasetenはWindowsやMacにインストールして使う一般的なAIアプリではありません。基本的にはクラウド上の管理画面、API、CLI、開発環境から利用します。
| 環境 | 利用方法 |
|---|---|
| Windows | Webブラウザ、CLI、開発環境から利用 |
| Mac | Webブラウザ、CLI、開発環境から利用 |
| Linux | CLI・開発環境との相性が良い |
| iOS | Web管理画面を利用 |
| Android | Web管理画面を利用 |
| ブラウザ拡張機能 | 専用拡張機能は基本的に不要 |
| API | 自社アプリやバックエンドから利用可能 |
つまり、Basetenでは「スマホにアプリを入れられるか」よりも「自分のアプリケーションからAIモデルを呼び出せるか」が重要です。
💰Basetenの料金プラン
Basetenの料金体系は、ChatGPT Plusのような月額固定型とは異なります。基本的には利用するモデルやGPU、コンピュート時間、API使用量などに応じて料金が変わる従量課金型です。
| プラン | 料金 | 特徴 |
|---|---|---|
| Basic | 月額0ドル+従量課金 | 個人開発や小規模なAIサービスの検証向け |
| Pro | 個別見積もり | より高い利用上限、優先コンピュート、企業向けサポートなど |
| Enterprise | 個別見積もり | 大規模運用、SLA、セルフホスト、セキュリティ要件への対応など |
Basicでは月額固定費なしで始められますが、AIモデルを実際に稼働させればコンピュートなどの利用料金が発生します。そのため、「無料で使える」と考えるより「初期費用なしで試せる従量課金型」と考えたほうが実態に近いでしょう。
また、Model APIを利用する場合はモデルごとに料金が異なります。入力トークン、出力トークン、キャッシュなどによって価格が変わるモデルもあるため、導入時には利用予定モデルの最新料金を確認する必要があります。
Basetenは「月額○ドルで無制限」というサービスではありません。ユーザー数、モデルサイズ、GPU、リクエスト数によって実際のコストは大きく変わります。
👥Basetenが向いているユーザー
| ユーザー | 適性 | 理由 |
|---|---|---|
| AIエンジニア | 非常に高い | モデルデプロイ、推論、GPU最適化に直接利用できる |
| MLエンジニア | 非常に高い | モデル開発から本番推論までの流れを構築しやすい |
| AIスタートアップ | 非常に高い | 少人数でもAIインフラを構築しやすい |
| 企業の開発チーム | 高い | セキュリティやスケーリングを含めて運用しやすい |
| プログラマー | 条件次第 | AI機能を自社アプリへ組み込みたい場合に有効 |
| マーケター | 低い | AIモデルのインフラを直接運用する必要がある場合を除いて用途が少ない |
| 一般ユーザー | 低い | AIを使うだけなら、完成済みAIサービスのほうが簡単 |
🌎Basetenの世界での利用状況
Basetenは一般消費者向けアプリではないため、ChatGPTのような月間アクティブユーザー数やアプリダウンロード数だけで規模を判断するサービスではありません。
Basetenが公表している企業情報を見ると、AIインフラ企業としての成長は大きく、AIスタートアップやAI企業を中心に採用が進んでいます。
特に注目したいのが推論処理量です。Basetenは近年、AI推論の処理量が大きく増えていることを公表しており、単なる実験用のモデルホスティングではなく、本番AIサービスのインフラとして利用されるケースが増えています。
また、AIモデルを開発する企業だけでなく、独自モデルをAPIとして外部へ提供したいModel Labs向けの機能にも事業領域を広げています。
一方、Basetenは一般ユーザーの国別利用率、国別アクセス数、正確な利用者数、アプリダウンロード数などを詳細には公開していません。そのため、日本の利用者が何%、米国が何%といった数字を推測して掲載するのは適切ではありません。
一般ユーザー数より、企業による採用、AI推論処理量、資金調達、提供モデル数、AIスタートアップとの連携などを見るほうが実態を把握しやすいサービスです。
⚖️Basetenのメリット・デメリット
メリット
- AI推論に特化している:GPUを借りるだけではなく、モデルを本番で運用するための仕組みが揃っています。
- スケーリングに対応しやすい:アクセス量の変化に合わせてコンピュートを調整できます。
- 独自モデルを持ち込める:オープンソースモデルだけでなく、自社モデルやファインチューニングモデルも扱えます。
- 企業向けの選択肢がある:セルフホストやハイブリッドなど、企業のインフラ要件に合わせた構成を取りやすくなっています。
- AI開発から本番運用まで広げている:推論だけでなくトレーニング領域にも対応範囲を広げています。
デメリット
- 初心者には難しい:AIチャットサービスのように登録してすぐ使うタイプではありません。
- 料金計算が複雑:モデル、GPU、リクエスト量、コンピュート時間などによってコストが変わります。
- 小規模プロジェクトでは過剰になりやすい:単純なAI API利用だけなら、よりシンプルなサービスで十分な場合があります。
- インフラ知識が必要:GPU、レイテンシー、モデルデプロイ、スケーリングなどの知識が求められます。
🔄Basetenと類似AIインフラサービスの違い
| サービス | 主な位置づけ | 向いている用途 | 特徴 |
|---|---|---|---|
| Baseten | AI推論・モデル運用基盤 | 本番AI、独自モデル、企業向け推論 | 推論性能、デプロイ、スケーリング、企業運用を重視 |
| Replicate | AIモデルAPI | AIモデルのAPI化、プロトタイプ | モデルを比較的簡単にAPIとして利用しやすい |
| Modal | サーバーレスGPU・クラウドコンピュート | AI処理、バッチ処理、GPUワークロード | コードベースで柔軟なGPU処理を構築しやすい |
| Together AI | LLM API・AI開発基盤 | LLM API、ファインチューニング、モデル利用 | 既存のLLMをAPIとして利用する用途にも向く |
| RunPod | GPUクラウド | GPUサーバー、AI開発、推論 | GPUコンピュートを柔軟に利用したい場合に向く |
| AWS / Google Cloud / Azure | 総合クラウド | AIを含む大規模システム全般 | 自由度が高い一方、AI推論基盤を自分で構築する範囲が広い |
この比較で重要なのは、単純なGPU単価だけでBasetenを評価しないことです。
RunPodのようなGPUクラウドは「GPUそのものを借りる」ことが中心です。一方、BasetenはそのGPU上でモデルをデプロイし、APIとして提供し、アクセス量に応じてスケールさせるところまでを重視しています。
そのため、どのサービスが合うかは、必要なGPUの種類だけでなく「どこまでインフラを自分で管理したいか」で変わります。
🎯Basetenを使う価値があるケース
Basetenの導入を検討するなら、「AIを使いたいか」ではなく「AIモデルを本番サービスとして運用したいか」を基準にすると判断しやすくなります。
向いているケース
- 独自AIモデルを本番サービスへ組み込みたい
- オープンソースLLMを大量のユーザーへ提供したい
- 推論速度を細かく最適化したい
- アクセス量に応じてGPUをスケールさせたい
- AIインフラの構築・保守にかかる開発工数を減らしたい
- 企業向けのセキュリティやデータ管理が必要
- 将来的にセルフホストやハイブリッド構成を検討している
あまり向いていないケース
- 単純にChatGPTのようなAIを使いたい
- 小規模な個人プロジェクトでAI APIを少し利用するだけ
- 自分でAIモデルをデプロイする予定がない
- GPUや推論速度を管理する必要がない
📌Basetenの総評:AIを「使う側」ではなく「提供する側」に向いている
Basetenを一言で説明するなら、AIモデルを本番サービスへ持っていくための推論インフラです。
ChatGPT、Claude、GeminiのようなAIサービスとは役割が違います。Basetenを使って文章を書いたり、画像を生成したりするのではなく、自分たちのAI機能をWebサービスやアプリの中へ組み込み、その処理を安定して動かすために利用します。
特にAIスタートアップや企業のAIプロダクトでは、モデルの精度だけではなく、応答速度、同時アクセス数、GPUコスト、スケーリング、セキュリティなども重要になります。
Basetenはまさにこの部分を担当するサービスです。
一方で、AIを個人で試してみたいだけなら、Basetenはかなり本格的です。モデルデプロイやGPU、API、スケーリングといった知識が必要になるため、一般ユーザーにとっては扱いやすいAIサービスとは言いにくいでしょう。
逆に、独自モデルを持っている、AI SaaSを開発している、LLMや画像生成モデルを大量のユーザーへ提供したい、といった段階なら検討する価値があります。
Basetenは「AIモデルを動かすだけ」のサービスではなく、「AIモデルを事業として提供する」ためのインフラに近い存在です。AIスタートアップ、MLエンジニア、AIプロダクトを開発する企業には使い道がありますが、一般ユーザーがAIを利用する目的で選ぶサービスではありません。
❓Basetenに関するよくある質問
BasetenはChatGPTのようなAIですか?
違います。ChatGPTはユーザーが直接利用する生成AIサービスですが、BasetenはAIモデルを自社サービスへ組み込むためのインフラプラットフォームです。
Basetenは無料で使えますか?
Basicプランでは月額固定料金なしで利用を開始できます。ただし、実際にモデルを動かせばコンピュートなどの利用料金が発生する従量課金型です。
Basetenはプログラミング初心者でも使えますか?
使い始めること自体はできますが、本格的なモデルデプロイにはAIモデル、API、GPU、クラウドインフラなどの知識が必要です。一般的なAIチャットサービスと同じ感覚で使うものではありません。
Basetenは自分のAIモデルを使えますか?
はい。オープンソースモデルや自社で開発したモデル、ファインチューニングしたモデルなどをデプロイする用途に対応しています。
BasetenにはWindowsやMac向けアプリがありますか?
一般ユーザー向けの専用デスクトップアプリをインストールして使うサービスではありません。Web管理画面、CLI、API、開発環境などから利用します。
BasetenとGPUクラウドは同じですか?
完全に同じではありません。GPUクラウドはGPUコンピュートを提供することが中心ですが、BasetenはAIモデルのデプロイ、推論、スケーリング、API提供など、本番AIサービスを動かすための仕組みまで扱います。
日本の企業でもBasetenを利用できますか?
利用できます。ただし、企業システムで導入する場合は、利用リージョン、データ保存場所、セキュリティ、契約条件、APIレイテンシーなどを事前に確認することをおすすめします。
コメント