
🔍 1. Fireworks AIとは何か
Fireworks AIはPyTorch開発者らが創業した米国のAIインフラ企業が提供する、オープンモデル向け高速推論・ファインチューニングクラウドプラットフォームです。Llama、Qwen、DeepSeek、GLMなど多数のオープンLLM・マルチモーダルモデルを、低レイテンシかつ低コストで本番運用するためのAPIを提供します。
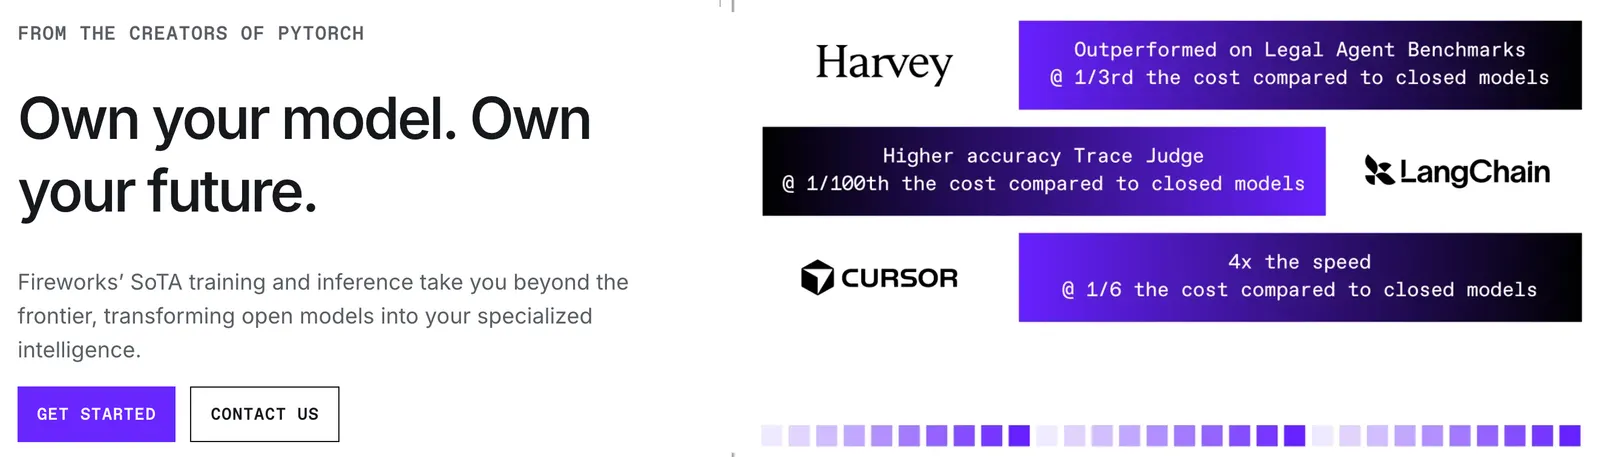
製品の位置づけは「オープンモデルに特化した本番向けAIクラウド」。OpenAI/AnthropicのAPIと互換性があり、既存コードを少し修正するだけで移行可能。独自のFireAttention推論エンジンとFireOptimizerにより、GPUのメモリ・量子化・スペキュラティブデコーディングを最適化し、オープンモデルの速度を大幅に引き上げる点が最大の特徴です。Cursor、Vercel、Sourcegraphなどに採用されています。
解決する課題:オープンソース大規模モデルのGPUインフラ管理、推論の遅延、スループット不足、ファインチューニングの環境構築コスト。自前でGPUクラスタを運用せず、オープンモデルを商用規模で安定運用できるようにします。
⚙️ 2. 主なコア機能(10項目)
- ⚡ FireAttention高速推論エンジン:独自の分散推論アーキテクチャで、高スループット・低遅延を実現。スペキュラティブデコーディングに対応
- 🧩 OpenAI互換API:OpenAIやAnthropicのメッセージAPIと互換。エンドポイントを差し替えるだけでアプリ移行可能
- 🎛️ FireOptimizerモデル最適化:量子化、カーネル、ハードウェア設定を自動選択し、モデルのコスト・速度を最適化
- 🔧 ファインチューニング(SFT/LoRA):オープンモデルに対して教師あり学習、LoRA微調整をクラウド上で実行、完了後即デプロイ
- 🌐 マルチモーダル対応:テキストLLM、画像理解VLM、音声文字起こしWhisper、埋め込み、画像生成に対応
- 🔄 バッチ推論:大量のリクエストを非同期で一括処理。コストを抑えた大規模タスク実行
- 🛠️ ツール呼び出し・構造化出力:Function Calling、JSON固定出力をサポート。AIエージェント開発に適している
- ☁️ 3種類のデプロイ方式:Serverless(トークン課金)、On-Demand(GPU秒課金)、Reserved(企業向け専用予約GPU)
- 🔀 Fireworks Nexus(FireRouter):複数モデルを動的にルーティング。用途ごとに最適なモデルを自動選択しコスト削減
- 📦 SDKと評価ツール:Python/JavaScript SDK、モデル評価・実験管理ツールを標準提供
✨ 3. 主な特長・他LLM APIプロバイダーと比較した強み
- ✅ オープンモデルの推論速度が非常に速い。独自最適化により、一般的なvLLMより低レイテンシ・高スループット
- ✅ OpenAI互換APIなので、既存のLangChain、LlamaIndexなどのエージェントフレームワークに簡単に差し替え可能
- ✅ LoRAを含むファインチューニングからデプロイまで一気通貫。自分のデータで特化モデルを素早く作成できる
- ✅ モデルライブラリが豊富:Llama、Qwen、DeepSeek、GLM、MiniMaxなど250以上のオープンモデルを即日利用可能
- ✅ 企業向けセキュリティ:SOC2、HIPAA対応、GDPR準拠。ユーザー入出力をモデル学習に利用しない方針
💼 4. 使用シーン
- 🧑💻 AIスタートアップ:独自AIアプリ・AIエージェントのバックエンドとしてオープンモデルを低コストで本番運用
- 🏢 企業内AI:社内データでLoRAファインチューニングした専用モデルをRAGシステムに搭載
- 💻 コーディングAI:CursorのようなAIコードアシスタントの推論基盤(コードモデルの高速実行)
- 📄 ドキュメント・画像解析:VLMを使った帳票OCR、図面解析、長文RAG検索
- 🧪 研究者・開発者:様々なオープンモデルを素早く試し、比較実験を行うプロトタイピング
📝 5. 使用手順:登録から操作フロー
- 🔹 アクセス:Fireworks AI公式サイトにアクセス、アカウント登録
- 🔹 APIキー取得:管理画面からAPIキーを発行。クレジットをチャージ
- 🔹 モデル選択:モデルライブラリから利用するLLM/VLM/埋め込みモデルを選定
- 🔹 API呼び出し:REST APIまたはPython/JS SDKでプロンプトを送信。OpenAI互換のコードで記述可能
- 🔹 ファインチューニング(任意):学習データをアップロード、LoRAまたはフルパラメータSFTを実行
- 🔹 ファインチューン済みモデルをデプロイ:学習完了後、専用エンドポイントとして公開
- 🔹 Nexusルーター設定(任意):複数モデルを登録し、タスクに応じて自動振り分け
- 🔹 モニタリング:ダッシュボードでトークン消費、レイテンシ、エラー率を確認
- 🔹 本番スケーリング:必要に応じてOn-DemandやReserved GPUに切り替え、安定性を向上
💡 6. 使用テクニック・出力品質を上げるコツ
- 🔹 最初はServerlessでプロトタイプ検証。トラフィックが増えてきたらOn-Demandに移行するとコスト最適
- 🔹 LoRAファインチューニングでは、データクオリティを重視。少量の高品質データでも十分効果が出る
- 🔹 OpenAI互換APIを活用し、LangChain/LlamaIndexのコードをほぼそのまま流用して素早くエージェントを作成
- 🔹 Nexusを利用し、簡単なタスクは小型モデル、複雑なタスクは大型モデルに自動振り分けてコスト削減
- 🔹 長文コンテキストを扱う場合、キャッシュ機能を活用してトークン費用と遅延を削減
- 🔹 本番利用時は、レイテンシ・スループットの負荷テストを事前に実施
💻 7. インストール・利用可能プラットフォーム
- 🌐 Web管理コンソール:ブラウザからアカウント管理、モデル実験、ファインチューニング実行
- 🔌 REST API:どの言語・環境からもHTTPリクエストで呼び出し可能
- 📚 SDK:Python、JavaScript/TypeScript公式SDKを提供
- 🧩 フレームワーク連携:LangChain、LlamaIndexなどと互換
- 🖥️ 専用デスクトップアプリ:なし。APIベースのクラウドサービス
💰 8. 料金体系
- 🪙 Serverless:トークン単位従量課金。入力トークン、出力トークン、キャッシュトークン別に課金。小規模実験・プロトタイプに適している
- ⚙️ On-Demand:GPU秒課金。H100/H200など、必要なときだけGPUを起動、オートスケール。中規模本番向け
- 🏢 Reserved(企業向け):専用GPU確保、SLA、マルチリージョン、BYOC。個別見積もり
- 🎓 ファインチューニング:LoRAとフルパラメータSFTで料金が異なり、学習トークンに対して課金
※補足:無料枠は限定的。クレジットチャージ式で、月額利用上限を設定してコスト暴走を防止可能。
👥 9. 適した利用者層
- 🧑💻 オープンLLMを本番で運用したいAI開発者、スタートアップエンジニア
- 🏢 社内RAG・専用AIエージェントを構築する企業のAIチーム
- 🔬 複数のオープンモデルを比較・評価したい研究者・MLエンジニア
- 🤖 AIコードアシスタント、ドキュメント解析、マルチモーダルアプリ開発者
- 📈 クローズドモデル(OpenAI等)からオープンモデルへ移行しコスト削減を狙うチーム
🌍 10. 世界の利用状況
Fireworks AIは北米を中心に、AIスタートアップや大手テック企業で広く採用されています。Cursor、Vercel、Sourcegraphなど有名なAI製品の推論基盤として利用されています。
日本ではオープンLLMを活用するAI開発チーム、RAGやAIエージェント開発者を中心に利用が広がっています。月間処理トークンは毎日30兆トークン超、秒間28万件以上のリクエストを処理する大規模インフラを持ちます。
✅❌ 11. メリット・デメリット分析
メリット
- オープンモデルの推論速度が強み。低遅延・高スループットで本番向き
- OpenAI互換APIのため、移行コストが低い。LangChain等と簡単に連携可能
- LoRAファインチューニングからデプロイまで一箇所で完結
- 多種多様な最新オープンモデルを即日利用可能。テキスト、VLM、音声、埋め込みに対応
- 企業向けのセキュリティ・コンプライアンス対応が充実
デメリット
- オープンモデルを扱うため、GPT-4oなどクローズドトップモデルと比べ、タスクによって品質が劣る場合がある
- 日本語ドキュメントが少なく、学習には英語ドキュメントを読む必要がある
- 自前でモデルの品質評価、プロンプト調整を行う必要がある
- 大規模GPUのOn-Demand/Reservedプランは、小規模開発者にはコストが高くなる可能性
- モデルのハルシネーションはオープンLLM共通の課題
⚖️ 12. 類似ツールとの比較
Fireworks AI vs Together AI
どちらもオープンモデル推論API。Fireworksは独自FireAttentionによる低遅延とファインチューニング一体型、Nexusモデルルーティングが強み。Together AIはモデル種類の豊富さとコミュニティ知名度が高い。
Fireworks AI vs OpenAI API
OpenAIはクローズドモデルで安定性・汎用性能が高い。Fireworksはオープンモデルを選べ、モデルの所有権を保持、コスト削減可能。OpenAI互換APIで差し替えられる。
Fireworks AI vs vLLM(自前ホスト)
vLLMはオープンソース推論エンジン。FireworksはvLLMよりさらに最適化されたクラウドマネージドサービス。GPUインフラ管理を丸投げできる代わりに、クラウド利用料が発生。
📌 13. まとめ:利用価値の評価
どんな人におすすめか
オープンLLMを高速かつ安定的に本番運用したい開発者、スタートアップ、企業AIチーム。OpenAIなどクローズドモデルから移行してコスト削減やモデルの自由度を求める人に最適。
使う価値がある場面
AIエージェント、RAGシステム、AIコードアシスタント、画像・ドキュメント解析アプリのバックエンド。独自データでLoRAファインチューニングした専用モデルの本番デプロイ。
推奨しない場面
複雑な推論・高度な汎用タスクで最高品質のクローズドモデルだけを使いたい場合。英語ドキュメントを読むのが難しく、日本語のサポートを強く求める場合。
総合評価:★★★★★(4.5/5)。オープンモデル推論クラウドのトップクラス。低遅延とファインチューニング一体型が強み。プロトタイプから大規模本番まで対応可能。
📝 最後のまとめ
Fireworks AIはオープンLLMの高速推論に特化したクラウドAIインフラで、OpenAI互換APIによる低コスト移行、LoRAファインチューニングからデプロイまで一気通貫のワークフロー、Nexusによる動的モデルルーティングが最大の魅力です。自前でGPUクラスタを構築・保守する手間を省略し、RAG、AIエージェント、マルチモーダルアプリなどを短期間でプロトタイプから商用環境まで構築できます。
一方、オープンモデル固有のハルシネーション、日本語資料の少なさ、トップクラスのクローズドモデルと比べると複雑な推論タスクで性能差がある点に注意が必要です。クローズドモデルの高いコストやモデル利用制限に悩む開発チームにとって、有力な代替選択肢となるサービスです。
コメント